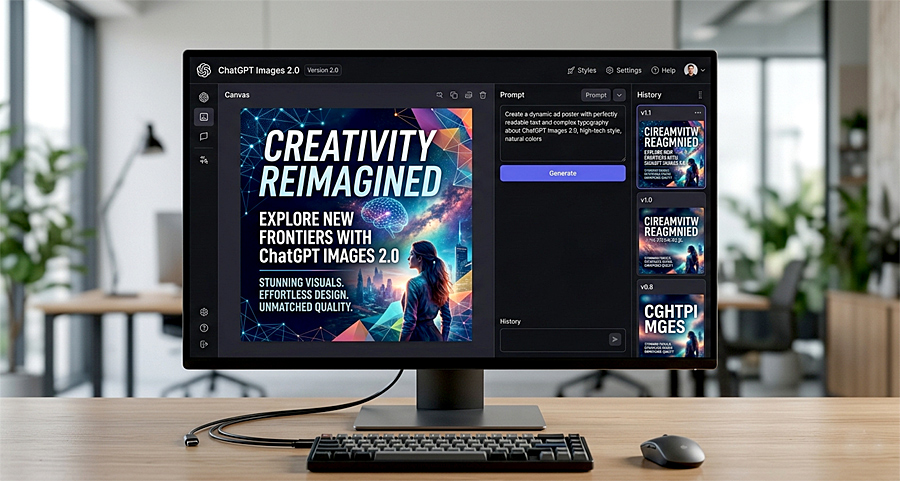
OpenAI представила обновлённую модель генерации изображений ChatGPT Images 2.0, которая стала заметным шагом вперёд в точности отрисовки текста внутри изображений. Главное изменение - система впервые стабильно и без типичных ошибок формирует читаемые надписи, включая мелкий шрифт, плотные композиции и сложные интерфейсные элементы, где предыдущие модели регулярно «ломали» слова или подменяли их бессмысленными символами.
По демонстрациям разработчиков, новая версия способна создавать изображения, где текст можно использовать без ручной корректировки - например, меню, постеры или рекламные макеты с корректной типографикой. Если ранние генераторы часто искажали слова вроде названий блюд или брендов, то Images 2.0 формирует их корректно даже в насыщенных сценах с большим количеством надписей.
Модель также улучшила работу со сложными сценами: поддерживает многослойные композиции, плотную верстку и сохраняет читаемость текста даже при высокой детализации. Отдельный акцент сделан на мультиязычность - система лучше справляется с нелатинскими языками и более уверенно обрабатывает сложные алфавиты, включая азиатские и индийские языковые группы.
Кроме того, заявлена возможность генерации изображений высокого разрешения до 2K, а также работа с более сложными пользовательскими инструкциями, где ИИ «рассуждает» перед созданием изображения и уточняет структуру сцены. Это делает модель более предсказуемой и пригодной для практических задач вроде дизайна, рекламы и интерфейсов.
Новости нейросетей
27.04.2026