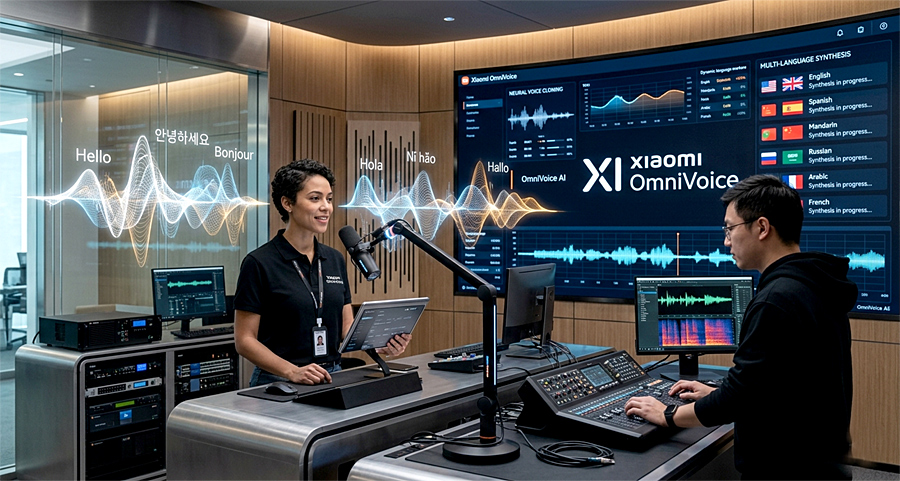
Xiaomi открыла доступ к новой нейросетевой модели OmniVoice, предназначенной для синтеза речи и клонирования голоса. Разработка поддерживает более 600 языков и диалектов, включая редкие и малораспространённые языки с минимальным объёмом обучающих данных. Компания утверждает, что система способна воспроизводить речь почти на любом языке, сохраняя тембр и особенности оригинального голоса.
OmniVoice построена на новой архитектуре diffusion language model и использует упрощённую схему генерации речи без сложных многоступенчатых модулей. Благодаря этому модель работает значительно быстрее большинства современных TTS-систем. Xiaomi заявляет о скорости генерации до 40 раз выше реального времени - десятисекундный аудиофрагмент может создаваться примерно за четверть секунды.
Для обучения OmniVoice использовали около 581 тысяч часов открытых аудиоданных. В тестах на 24 и 102 языках модель показала высокий уровень разборчивости речи и точности передачи голоса, а по ряду параметров превзошла коммерческие решения. Система умеет копировать голос по короткому образцу аудио, поддерживает управление акцентом, эмоциями, скоростью речи и даже добавление звуков вроде смеха или шёпота.
Код, веса модели и инструменты для запуска уже опубликованы на GitHub и Hugging Face по открытой лицензии Apache 2.0. Xiaomi рассчитывает, что OmniVoice будет использоваться в голосовых помощниках, локализации видео, играх, аудиокнигах и AI-сервисах нового поколения.
Новости нейросетей
11.05.2026