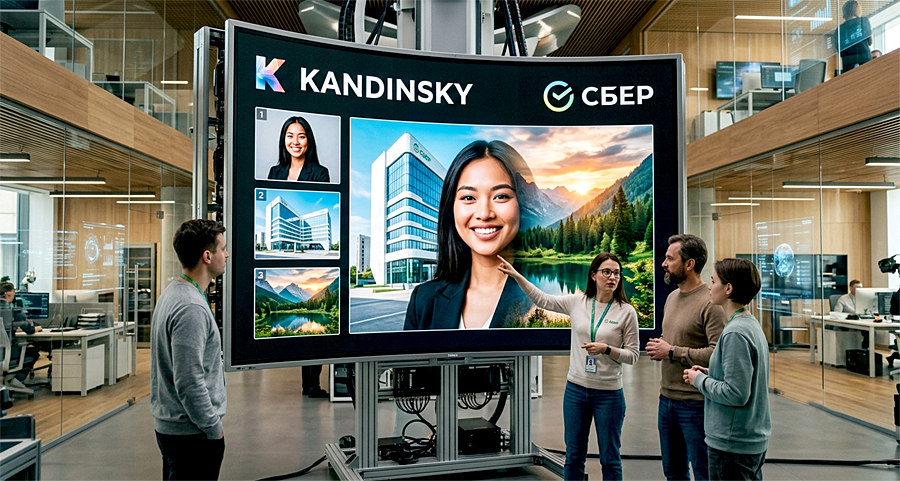
Обновлённая версия нейросети Kandinsky получила функцию, которая позволяет создавать единое изображение на основе сразу нескольких загруженных фотографий. Теперь пользователь может объединить несколько исходных снимков в одну композицию, сохраняя ключевые элементы каждого кадра - объекты, людей, стиль или фон. Это заметный шаг вперёд по сравнению с классической генерацией по одному изображению или текстовому запросу.
Разработчики отмечают, что алгоритм научился более точно анализировать структуру исходных фотографий: выделять главные объекты, распознавать сцены и корректно совмещать визуальные элементы без искажений пропорций. В результате система способна, например, объединить портрет человека с отдельным фоном, добавить элементы интерьера из другого снимка или перенести стилистику одного изображения на другое, сохраняя реалистичность сцены.
Особый акцент сделан на стабильности результата: количество визуальных артефактов и «размытых» зон снижено примерно на 30-40% по сравнению с предыдущей версией модели. Также улучшена работа с деталями лица, текстурами одежды и сложными объектами вроде архитектуры или природы.
Функция ориентирована как на обычных пользователей, так и на дизайнеров, маркетологов и контент-креаторов, которым нужно быстро собирать визуальные концепции без сложного редактирования. В практических сценариях Kandinsky может использоваться для создания рекламных макетов, визуальных прототипов и креативных коллажей буквально за несколько секунд.
Обновление усиливает позиции российской генеративной экосистемы Сбера в сегменте мультимодального ИИ, где ключевым трендом становится не просто генерация изображений, а интеллектуальное объединение визуальных данных из разных источников в единый осмысленный результат.
Новости нейросетей
15.06.2026