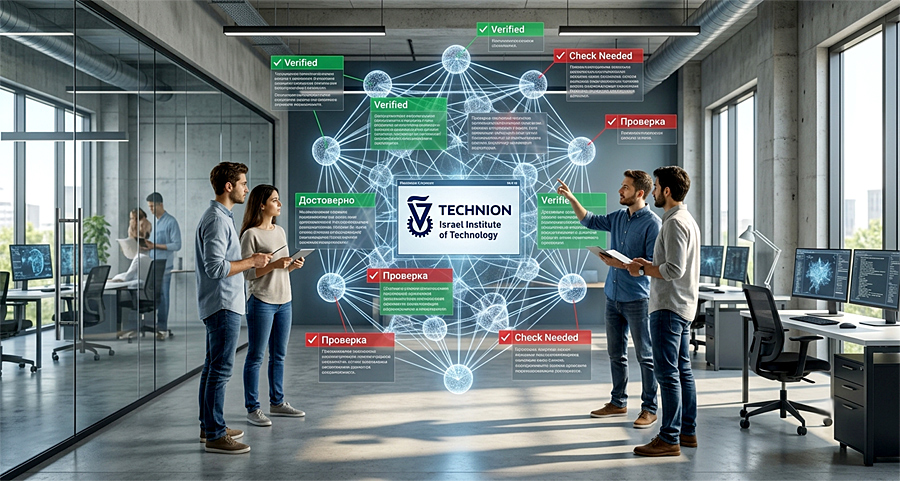
Исследователи из Израиля представили новую технологию, которая позволяет обнаруживать так называемые «галлюцинации» искусственного интеллекта ещё до того, как пользователь примет ошибочный ответ за достоверный. Разработка направлена на повышение надёжности больших языковых моделей, которые всё чаще используются в медицине, образовании, программировании, научных исследованиях и корпоративных сервисах.
Под «галлюцинациями» понимаются ситуации, когда нейросеть формулирует убедительно звучащие, но фактически неверные сведения, несуществующие ссылки, ошибочные даты или вымышленные цитаты. Новая система анализирует не только итоговый ответ модели, но и внутренние признаки процесса генерации текста. Алгоритм оценивает степень уверенности ИИ, сопоставляет вероятность различных вариантов ответа и выявляет характерные паттерны, указывающие на повышенный риск ошибки.
По словам разработчиков, предложенный подход способен заранее предупреждать пользователя о потенциально недостоверной информации без необходимости полностью изменять архитектуру существующих языковых моделей. Это позволяет интегрировать систему в уже работающие ИИ-сервисы, снижая вероятность распространения ложных данных и повышая доверие к результатам работы искусственного интеллекта.
Авторы исследования считают, что подобные инструменты особенно важны по мере массового внедрения генеративного ИИ. Чем чаще нейросети используются для принятия решений и подготовки профессиональных материалов, тем выше становится ценность механизмов автоматической проверки достоверности. Если технология подтвердит эффективность при масштабном внедрении, она может стать важным элементом безопасности будущих поколений интеллектуальных помощников.
Новости нейросетей
03.07.2026