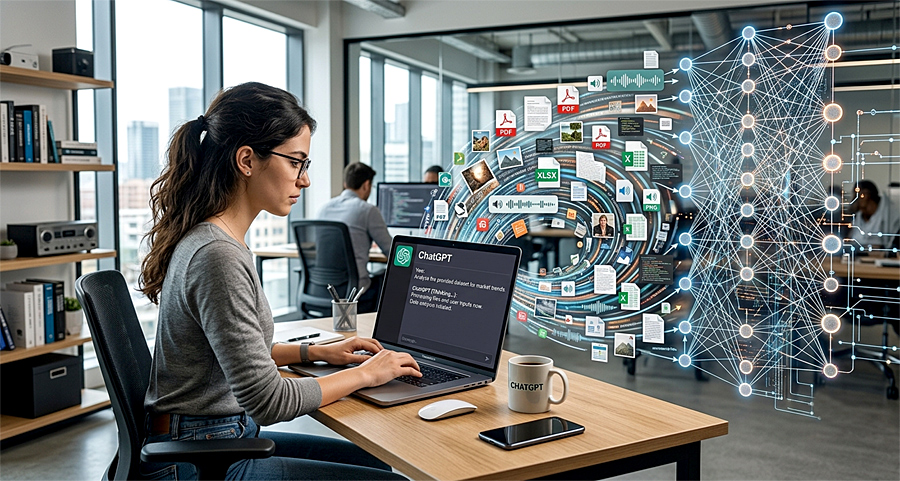
Развитие генеративного искусственного интеллекта сопровождается быстрым увеличением объема данных, которые компании используют для обучения и совершенствования своих моделей. Специалисты по цифровой безопасности отмечают, что современные ИИ-платформы уже анализируют не только открытые интернет-страницы, но и широкий спектр пользовательского контента - от голосовых запросов и текстовых диалогов до фотографий, документов и видеоматериалов, если это предусмотрено условиями использования сервиса.
Эксперты обращают внимание, что многие пользователи по-прежнему не изучают настройки конфиденциальности и автоматически соглашаются с обработкой информации при регистрации. В результате часть переписки с чат-ботами, изображения, загруженные файлы или голосовые команды могут использоваться для улучшения алгоритмов, если такая возможность разрешена политикой конкретной платформы.
Особое внимание специалисты советуют уделять корпоративным документам, персональным фотографиям, финансовым данным и другой чувствительной информации. Даже если крупные разработчики внедряют механизмы анонимизации и защиты данных, пользователям рекомендуется заранее проверять, можно ли отключить использование своих материалов для обучения искусственного интеллекта. Многие популярные сервисы уже предоставляют такую функцию в настройках аккаунта, однако она далеко не всегда активирована по умолчанию.
По мнению аналитиков, в ближайшие годы вопросы прозрачности обработки данных станут одним из главных направлений развития рынка искусственного интеллекта. Компании будут вынуждены предлагать пользователям более понятные инструменты управления конфиденциальностью, а возможность самостоятельно выбирать, какие материалы могут использоваться для обучения нейросетей, постепенно станет отраслевым стандартом.
Новости нейросетей
20.07.2026