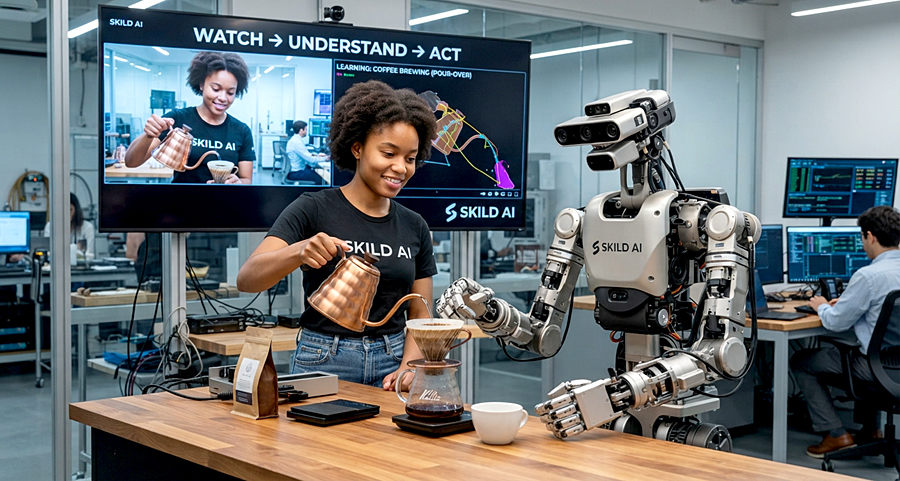
Skild AI представила S1 - робототехническую foundation-модель, которая переносит принцип in-context learning из языковых моделей в физический мир. Вместо длительного обучения новой задаче роботу достаточно показать одно видео с демонстрацией: S1 анализирует действия человека и использует увиденную последовательность как инструкцию для самостоятельного выполнения. Компания представила модель в сентябре 2026 года.
Главная особенность S1 - работа с задачами, которых не было в обучающей выборке. Модель способна выполнять многоэтапные сценарии продолжительностью до 10 минут, не требуя task-specific fine-tuning или дополнительного post-training. В демонстрациях Skild AI робот осваивал пересадку растения, приготовление кофе методом pour-over, сборку набора и приготовление блинов - причём каждая задача задавалась одной визуальной демонстрацией.
Для сложных сценариев это особенно важно: роботу приходится не просто повторить отдельное движение, а запомнить последовательность действий, отслеживать прогресс, комбинировать навыки и восстанавливаться после ошибок. В эксперименте с ранее невиданными задачами Skild AI сообщает примерно о 7-кратном преимуществе in-context learning по сравнению с управлением через языковой промпт.
Показателен и реальный тест с пересадкой растения. В 21:22 была записана одна человеко-ориентированная видеодемонстрация, а уже в 21:27 S1 начала автономное выполнение на роботе. Весь путь от начала эксперимента до самостоятельной работы занял около 11 минут, включая подготовку помещения.
S1 меняет саму идею обучения робота: вместо отдельной программы под каждую новую операцию модель получает возможность «посмотреть - понять - выполнить».
Новости нейросетей
04.09.2026