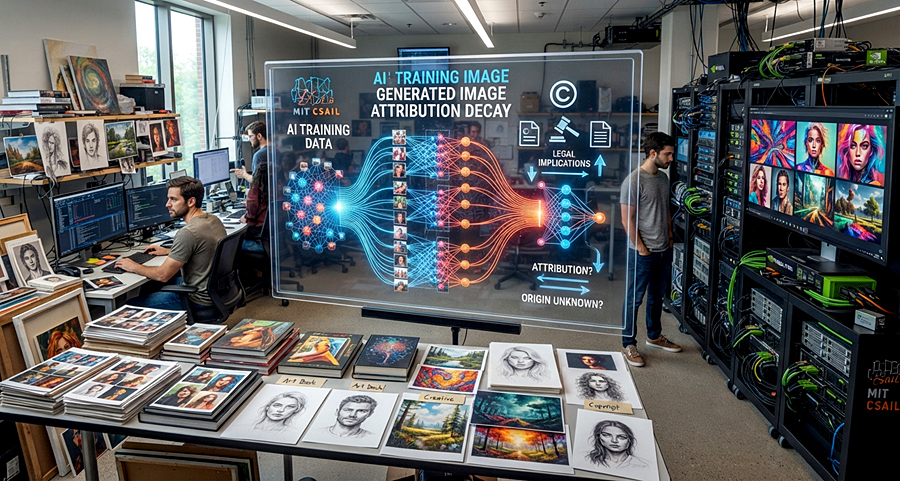
Исследователи Лаборатории компьютерных наук и искусственного интеллекта MIT CSAIL получили экспериментальные данные, показывающие: по мере увеличения обучающего набора генеративная нейросеть всё слабее зависит от отдельных изображений, использованных при обучении. Иными словами, установить прямую связь между конкретной фотографией из датасета и результатом работы ИИ зачастую становится практически невозможно.
Учёные назвали обнаруженный эффект «затуханием атрибуции» (attribution decay). Его суть можно представить на простом примере: если удалить из большого массива данных одну фотографию, изображения, создаваемые моделью, могут практически не измениться. При достаточно крупных наборах аналогичный результат наблюдается даже при исключении всех изображений конкретного художника или фотографий определённого человека.
Для проверки гипотезы исследователи разработали специальную архитектуру diffusion ensemble - диффузионный ансамбль. Вместо одной монолитной модели система состоит из множества небольших компонентов, каждый из которых обучается на отдельной части данных. Это позволяет отключить компонент, которому было доступно конкретное изображение, и посмотреть, насколько изменится результат генерации.
Экспериментальные результаты сравнивали с работой 24 обычных диффузионных моделей, обученных на тех же наборах данных. По стандартным показателям качества изображения оказались сопоставимыми. Затем исследователи последовательно исключали отдельные изображения и оценивали изменения результата как на уровне пикселей, так и по смысловому содержанию.
Для количественной оценки ввели показатель counterfactual radius - «контрфактический радиус», характеризующий максимальное влияние отдельного элемента обучающего набора. Чем больше становится датасет, тем меньше этот показатель: вклад одной конкретной фотографии постепенно растворяется среди огромного количества других данных.
Результат может иметь серьёзные последствия для продолжающихся споров об авторских правах на контент, используемый при обучении ИИ. Однако делать окончательные юридические выводы пока рано: исследование касается генерации изображений, а аналогичный эксперимент с языковыми моделями ещё не проводился.
Новости нейросетей
06.09.2026