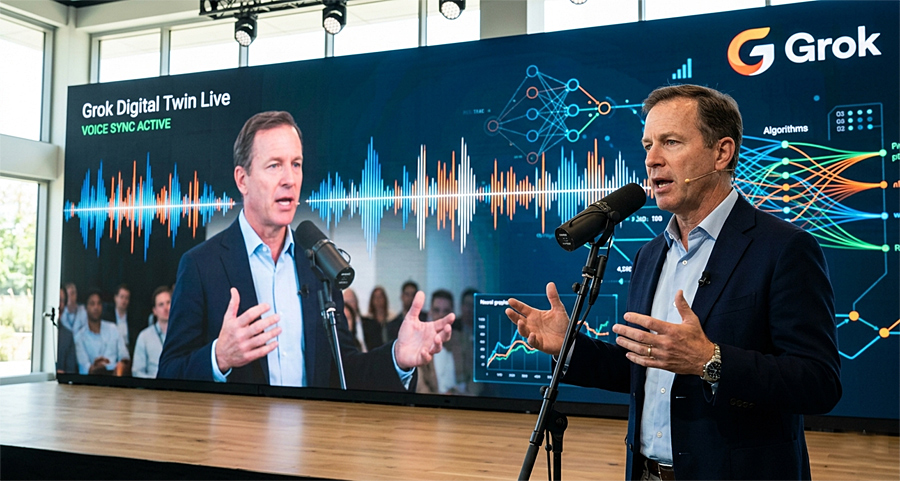
Технологии синтеза речи на базе ИИ вышли на новый уровень: современные системы способны воспроизводить голос человека с минимальным исходным материалом - иногда достаточно 10–30 секунд записи. Платформы вроде Grok и других решений активно внедряют функции голосового клонирования, делая их доступными не только студиям, но и обычным пользователям.
Ключевое отличие новых моделей - точная передача интонации, пауз, тембра и даже эмоциональных оттенков. Речь перестаёт звучать «синтетически»: алгоритмы обучаются на больших аудиодатасетах и используют нейросетевые архитектуры, которые моделируют поведение голосовых связок и дыхания. В результате созданный голос практически неотличим от оригинала в коротких диалогах и голосовых сообщениях.
Практическое применение быстро расширяется. Пользователи создают персональные голосовые ассистенты, озвучивают тексты, генерируют аудиоконтент и автоматизируют коммуникацию. Бизнес использует такие решения в поддержке клиентов и маркетинге, снижая затраты на запись и ускоряя производство аудио.
Однако вместе с ростом качества усиливаются и риски. Эксперты отмечают увеличение числа случаев голосового фишинга: поддельные звонки и сообщения становятся сложнее распознать. На этом фоне компании начинают внедрять защитные механизмы - цифровые водяные знаки и системы верификации речи.
Фактически голос становится ещё одним типом цифровой идентичности, который теперь можно воспроизвести с высокой точностью и минимальными затратами.
Новости нейросетей
07.05.2026